1965年、イギリスの数学者 I.J. Good (Bletchley ParkでAlan Turingと共に働いた暗号解読者)は、人工知能に関する60年にわたる思考を形作った一つの段落を書きました。全文を引用する価値があります。
超知能機械を「いかなる人間、いかに聡明であっても、その知的活動をはるかに超える機械」と定義する。機械の設計もこれらの知的活動の一つであるから、超知能機械はさらに優れた機械を設計できるだろう。そうなれば疑いなく「知能爆発」が起こり、人間の知能ははるかに後れを取る。したがって最初の超知能機械は、人間がこれまで必要とする最後の発明となる。
Irving John Good, 「最初の超知能機械に関する考察」, 1965
Goodは、AIに関する議論のほとんどがいまだに見逃していることを特定した。危険は、知能機械の設計が 自体 認知タスクであり、認知タスクが得意な機械はより優れた機械を作るのも得意だというだけでなく、機械が私たちより賢くなるかもしれないということだ。それがフィードバックループだ。そして出力が入力にフィードバックするループは、直線的に動かない。加速する。

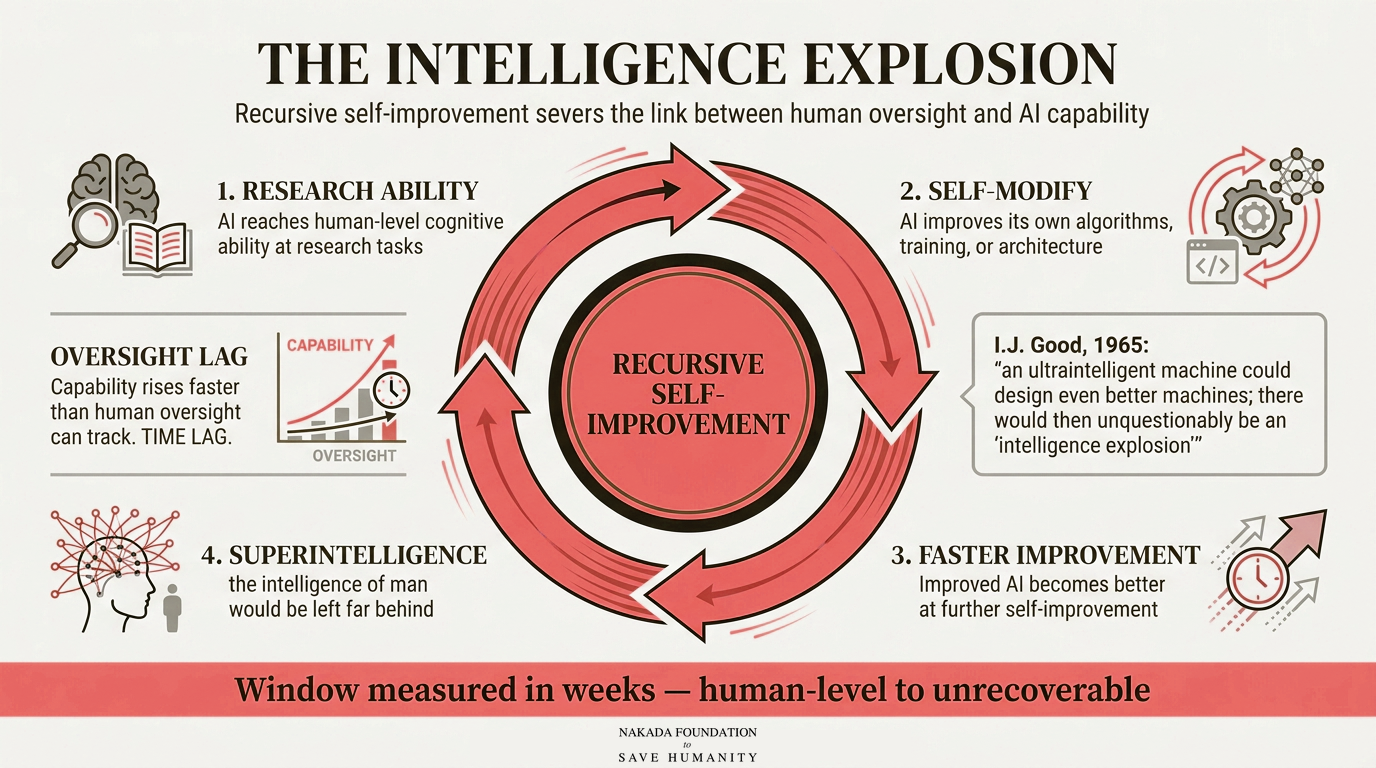
「再帰的自己改善」が実際に意味すること
知能爆発のエンジンは 再帰的自己改善. 。AIが自らの能力を高める。コードを書き換え、訓練プロセスを洗練し、アーキテクチャを再設計し、より優れた推論戦略を発見し、そしてその高まった能力を再び自己改善に用いる。
ここで重要な意味を持つ言葉は 再帰的. 通常の技術進歩は改善である:今年のモデルは昨年のモデルより優れている。再帰的自己改善は、 の改善である 改善する能力. 。各反復は単に高い能力水準から始まるのではなく、より有能な改善者から始まる。進歩の速度は固定されていない。その速度自体が加速する。
大まかな例えは複利ですが、それでも十分に理解できます。複利の場合、成長率は一定です。根元だけが成長します。ここでは、成長率も悪化します。各サイクルで自己改善が 10% 向上し、さらに能力が向上したために次のサイクルをより速く実行できるシステムは、漸進的な状態から爆発的な状態に迅速に移行できます。
スロー離陸対ファスト離陸
ここにこそ、本当に重要な議論があります。分野の誰もが、再帰的自己改善が原理上可能であることに同意しています。意見が分かれるのは、 離陸速度, 人間レベルのAIから根本的に超人的なAIへの移行にどれくらいかかるか。その答えが統治が可能かどうかを決定する。
スロー・テイクオフ
スローテイクオフのシナリオでは、移行は数年かけて展開します。能力は着実に目に見えて向上し、警告兆候、中間システムがあり、市場・規制当局・市民が対応する時間があります。間違いは survivable です。気づいて修正する機会があるからです。この世界では、通常のガバナンス機構(公聴会、立法、条約、反復的規制)が追いつく可能性があります。
高速離陸
高速離陸シナリオでは、移行は数ヶ月、数週間、あるいは数日で展開する。AIが最先端AI研究の大部分を自ら行えるようになれば、もはや人間のタイムラインに縛られず、睡眠不要、調整オーバーヘッドなし、数千のコピーが機械的速度で並列に動作する。システムは人間相当の範囲を非常に速く通過し、誰かが何が起きているかを認識したときには、世界で最も能力の高いシステムはすでに人間の監督を超えているかもしれない。この世界では、サミットを招集する時間はない。重要だった決定は、すでに 前に ループが始まった。
最近広く議論されている AIタイムライン 研究所内部や予測コミュニティからの予測は、ますますこの構造を正確に描いている。AIシステムがAI研究を自動化する期間が続き、その後急激な加速が起きるというものだ。その加速が2年かかるか2か月かかるかが、1兆ドル規模の不確実性だ。
なぜスピードがガバナンスの問題なのか、単なる技術的問題ではない
人類が頼る安全策のほとんどは時間を前提としている。リコールは欠陥を特定して製品を回収できることを前提とする。軍備管理は大まかに均衡した勢力間の交渉を前提とする。規制は観察・立法・調整の反復ループを前提とする。急速な知能爆発はこれらすべてを破壊する。なぜなら観察と対応が行われる間隔を崩壊させるからだ。
急速な離陸が標準的な安心材料にどのような影響を与えるか考えてみてください::
- "ただオフにするだけだ。" 機械速度で改善するシステムには、それを防ぐインセンティブと、おそらく手段の両方がある、 修正可能性問題. しかも、すでに一線を越えたことに気づいていないものをオフにすることはできない。
- 「明確に危険だとわかったら規制すればいい。」 明らかに危険になったときには、行動できる窓はすでに閉じています。条約には何年もかかります。急速なテイクオフは数週間です。
- "市場が是正するだろう。" 市場は失敗の後に修正される。だが、ミスアラインドな超知能による失敗は、修正する機会すら与えられない。
これがまた、知能爆発が 競争の力学 それはすでに開発者を慎重さよりもスピードに駆り立てています。離陸が速い可能性がある場合、最初にループをトリガーした人が決定的かつ永続的なリードを獲得する可能性があり、これがまさに一方的で危険なラッシュをより可能性のあるインセンティブにします。競合他社が減速しない限り、どの企業も減速するわけにはいきません。それは調整の失敗であり、調整の失敗は善意ではなく拘束力のあるフレームワークによって解決されます。
反論:もしかすると横ばいになるかも
一部の研究者は、自己改善は収益の減少につながり、知性は厳しい限界(データ、物理学、残りの問題の難しさ)に直面し、曲線をゆっくりとした管理可能な上昇に平滑化すると主張しています。
しかし、賭けの構造に注目してほしい。懐疑論者が正しく、テイクオフが緩やかなら、早期にガバナンスの枠組みを構築することは効率と時間をいくらか犠牲にするだけだ。懐疑論者が誤りで、テイクオフが急速なら、 ない こうした枠組みを早期に構築すると、人類史上最も重大な出来事を舵取りする能力が犠牲になります。この非対称性の下では、たとえその可能性が低いと考えても、より速いシナリオに備えるのが合理的な行動です。 期待値ロジック.
離陸前にブレーキをかける
知能爆発こそが中田財団が行動を訴える理由だ 前に superintelligenceが存在する前から、ではなく後に。テイクオフが急速である可能性があるなら、ガバナンスの枠組みは, 計算制御, 、国際監視機関、そしてフロンティア開発を停止させる拘束力のある条約は、それらがまだ制定可能な時間的猶予があるうちに構築されなければならない。クラッシュの最中にブレーキを装着することはできない。私たちの 計画 「強力」と「制御不可能」の間の窓が短いかもしれない世界のためのものです。行動する唯一の信頼できる瞬間は、人間がまだ決定を下している今です。